
录音降噪教程:先降噪还是先提音量,顺序错了全白做
按顺序使用的工具
最后得到什么: 一段音量和干净程度都够用、能转录也能发出去的语音录音。
真房间里录出来的声音,和你想象的不一样。有风扇、有冰箱、有车流,说话的人离麦克风三米远。通常两个问题一起来:太小声,也太吵。
直觉是先调大音量,因为那是最明显的问题。这个顺序是错的,后面会解释为什么。
降噪能做和不能做的
降噪跑的是 RNNoise,按短帧处理,判断哪部分是人声、哪部分是噪声。这个设计直接决定了它的边界:
稳态噪声处理得好。 风扇声、空调声、房间底噪、远处的车流——频谱稳定的都行。
背景里的说话声处理得差。 那是语音不是噪声,模型会保留下来,而且可能把人声弄坏。
被盖住的字救不回来。 噪声把某个音节完全盖住,那个音节就是没了,任何处理都还原不出。
会损伤音乐。 录音里有音乐的话,处理后通常会变怪。这是个人声工具。
先判断你手上是哪种情况,再决定要不要走这套流程。
第一步:把音频从视频里取出来
现场录音常常装在视频容器里:手机拍的视频、录屏、相机文件。
用音频提取把音轨取出来。后面每一步都是跟一个 40 MB 的音频打交道,而不是 2 GB 的视频,速度和整理难度都不一样。
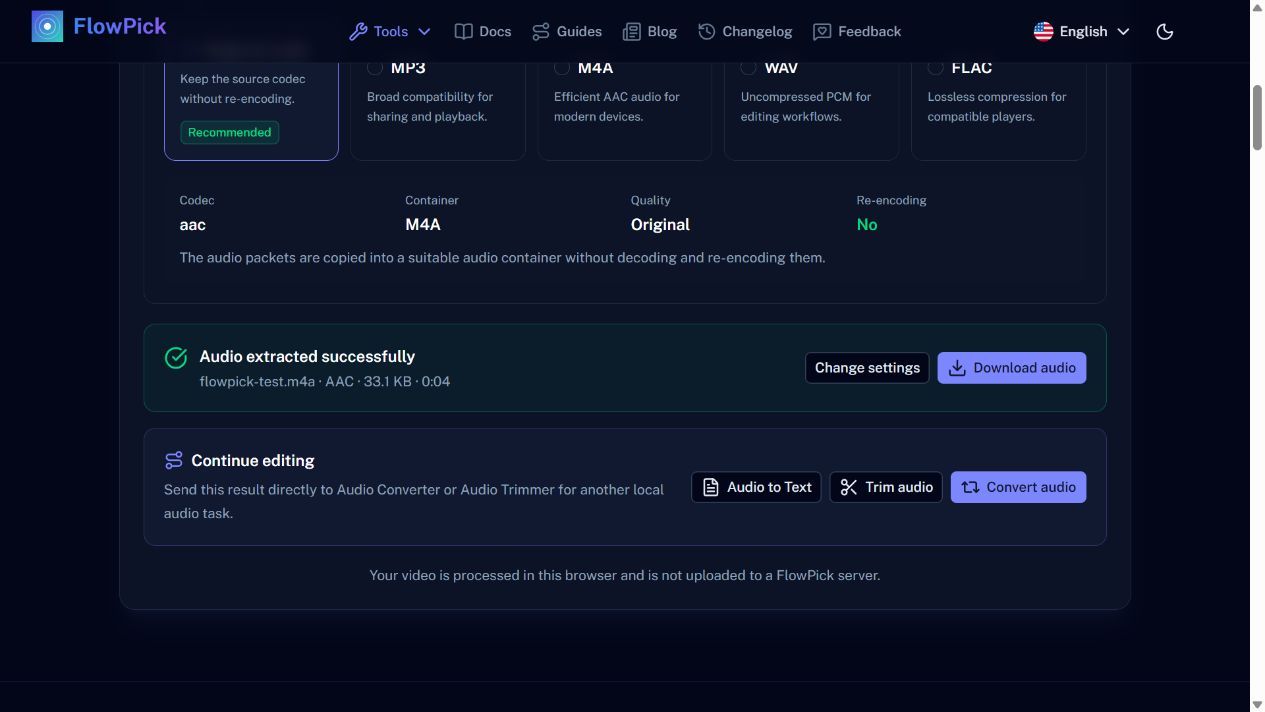
英文界面,生成的四秒 MP4 → 33.1 KB AAC/M4A 音频。Original audio(原始音频)模式直接拷贝音频数据,不重新编码。
源本来就是音频文件的话,跳过这步。
第二步:先降噪,再提音量
这是决定结果的一步。
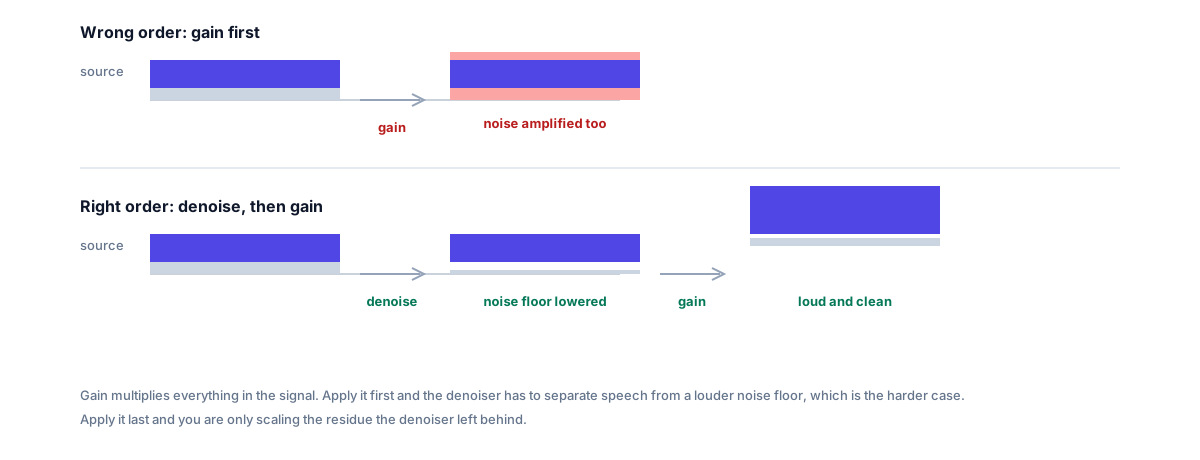
先加增益,噪声也一起加。降噪器面对的是一个更响但同样脏的信号,判断并不会更准。
先调大音量,所有东西都跟着变大,噪声也一样。降噪器随后看到的是一个更响但噪声比例没变的信号,它的估计不会更好——而你的耳朵这时候更容易听出处理痕迹。
所以顺序是:用降噪打开原始电平的文件处理,干净了之后再谈音量。
两个设置要留意:
先预览。 工具默认处理前 30 秒作为预览。长文件一定要先听预览,因为全量处理要等很久,而结果未必更好。
降噪比例。 输出是按百分比混合的,值越低,混回原音的部分越多。拉满降得最干净,但人声的质感也去得最多,听起来像被处理过。准备发出去的素材,一般不要拉满;只准备用来转录的,可以拉高一些。
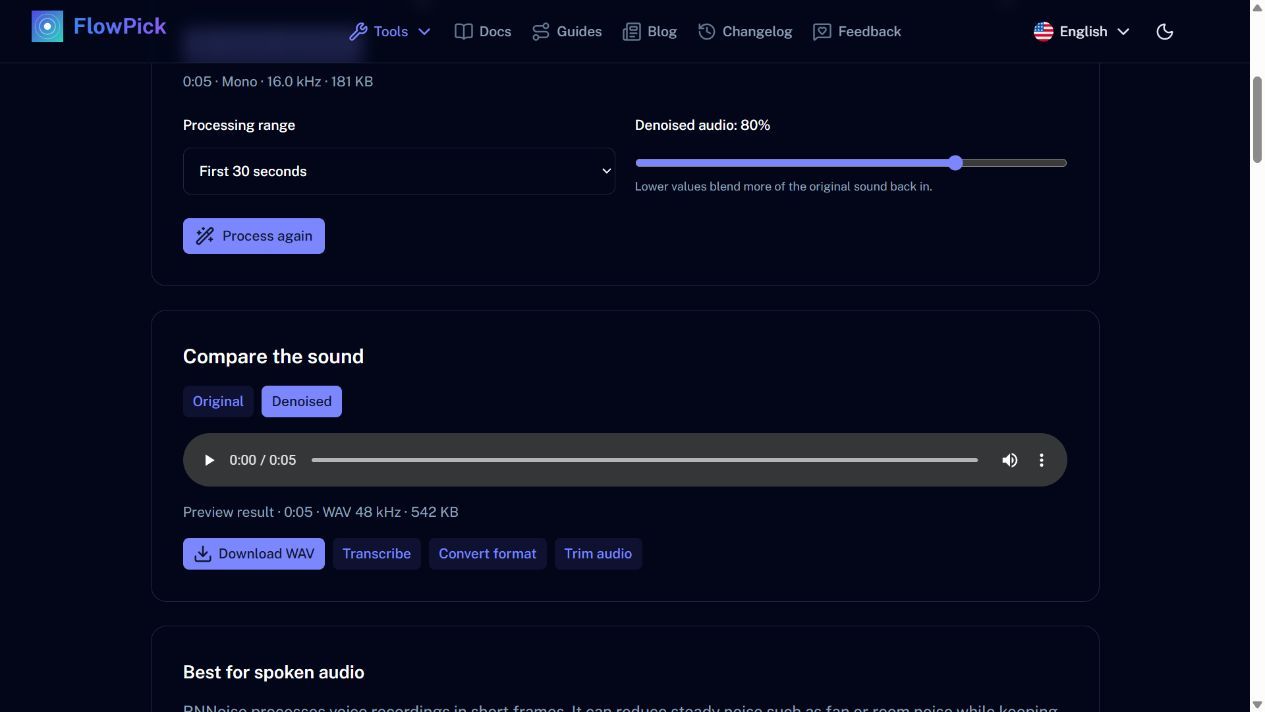
英文界面,使用生成语音、80% 混合比例演示。这不是嘈杂的现场录音,也不是语音质量改善的实测证据。
工具单文件上限 30 分钟。更长的要切分——顺便也是把用不上的部分去掉的理由。
第三步:小幅度提音量
现在录音干净了,但还是小声。用音量提升处理。
提到听着舒服就行,不要提到响。两个原因:
- 提音量也会把残留的噪声一起提上来,而降噪之后残留的往往是人声换气那种嘶声,模型没能分离干净。
- 一旦削顶——峰值撞到上限——损伤是永久的。留出余量。
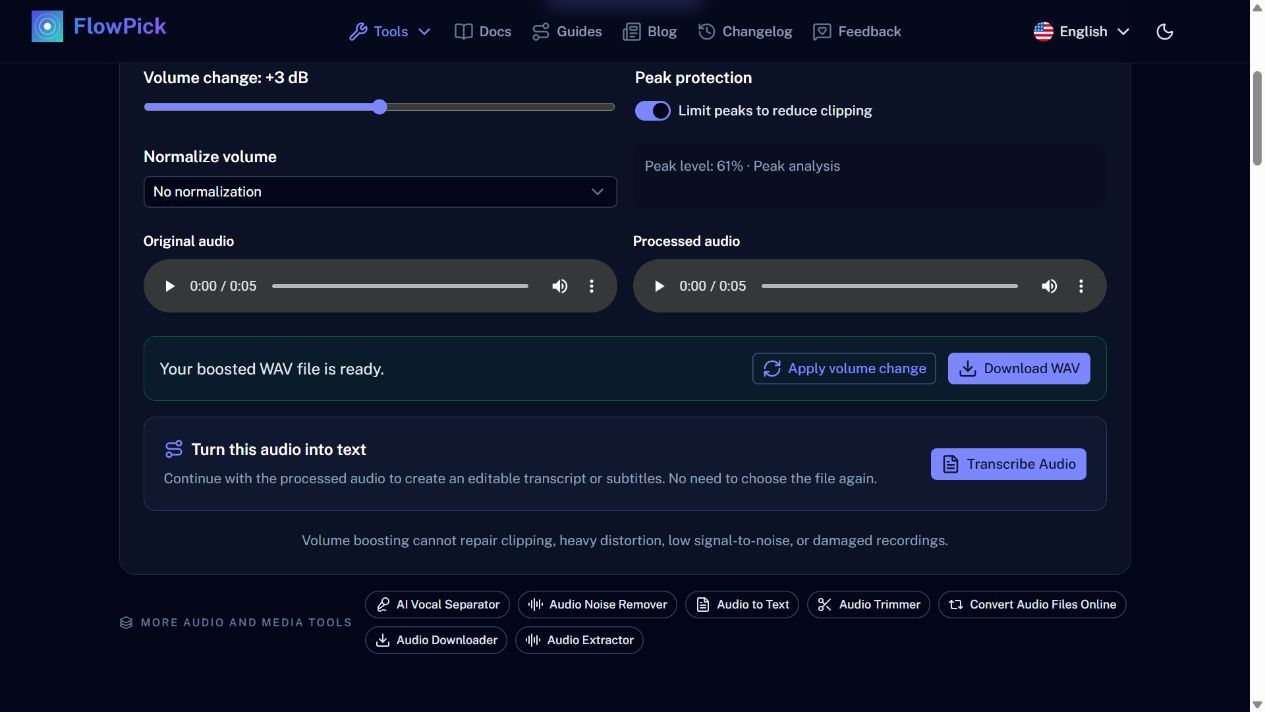
英文界面,生成语音使用 +3 dB 增益并开启峰值保护。显示的 61% 是源音频峰值分析;当前界面没有显示实测输出峰值。
注意齿音:"s"和"sh"这类音是最先失真的,增益给多了就刺耳。
第四步:先想清楚这个文件要干什么用
同一段录音,用途不同,处理方式就不同。导出之前先明确:
只用来转录。 降噪可以重一些,音量适中就好。识别对底噪的敏感度高于绝对响度。处理完交给音频转文字。
要发出去给人听。 降噪轻一些,音量做统一。过度处理的人声,听感比轻微的背景噪声更糟。
还要继续在剪辑软件里用。 导出处理后的 WAV,最后那几 dB 留给剪辑软件做。别在这里一步到位。
处理结果不对劲?先对号入座
听起来像机器人。 降噪过头了。回到原文件、降低比例重跑;这个处理不是增量的,必须从源头重来。
噪声还在。 多半是它本来就不是稳态噪声,或者相对人声太响了。判断一下是风扇声(该有效果)还是旁边有人说话(不会有)。
人声又远又薄。 麦克风离得远。降噪加不了距离感,它只能去掉不是人声的部分,而远处的说话本来就没多少"贴脸"的成分。
文件变大了。 降噪输出固定是 WAV,不管输入是什么格式。在意体积就用音频转换转成 MP3 或 M4A。
期望值放在哪
一段对它的用途来说够用的录音,以及一个诚实的判断:隔着房间用手机录的,不会变成演播室访谈,但它可以变成一份完全可搜索的文稿——而那往往才是真正的目的。