
人声分离怎么做?在浏览器里把歌曲拆成人声和伴奏
按顺序使用的工具
最后得到什么: 两条 WAV——人声和伴奏——来自一段你有权处理的音频。
把混好的曲子拆成人声和伴奏,听起来像个魔术,直到你真的试一次。结果有用,但也明显不完美。开始之前分清这两点,能省掉一下午的失望。
这个工具实际在做什么
它跑的是 Kim Vocal 2,一个被训练来判断"混音里哪部分属于人声、哪部分属于其他"的模型。输出两条轨:
- 人声——模型判断为嗓音的部分
- 伴奏——模型判断不是嗓音的其余部分
两条都是 WAV。全程不上传,模型和运行时首次下载约 64 MB,之后在本地跑。
它不是什么:不是无损还原。工具自己的说明就写了,分离可能在人声里留下乐器、也可能改变人声本身。鼓和镲尤其容易漏进人声轨,处理痕迹重的唱段拆出来会偏薄。这不是参数没调好,是这个层级的技术就这样。
开始之前:两个限制决定流程
单文件最长十分钟。 超过就直接拒绝。这就是流程里必须有裁剪这一步的原因——不是讲究,是硬限制。
一次一个文件,只支持桌面端。 这是桌面预览版,不是批量工具。扔一个文件夹进去是做不到的。
还有一个授权问题值得说清楚:处理你自己拥有或已获授权的音频。把一首商业曲子拆开,并不等于你获得了这两条分轨的使用权。
第一步:裁到你要的那一段
用音频裁剪把源文件切到十分钟以内。
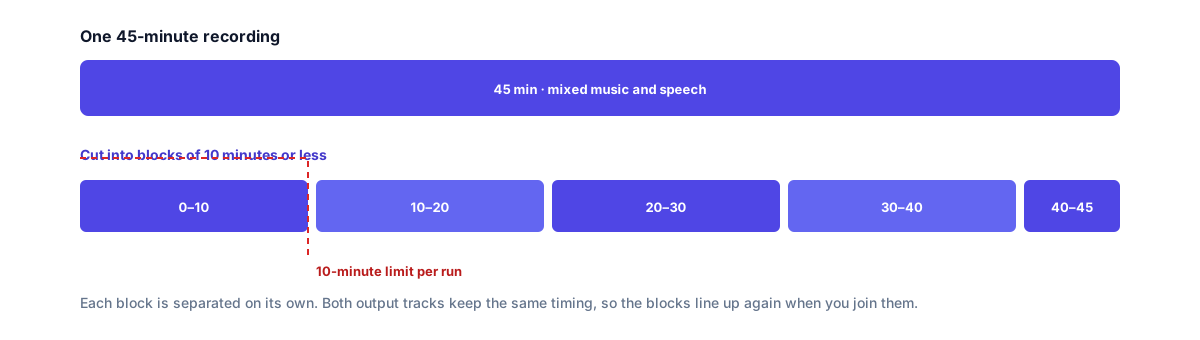
要的那段超过十分钟就切成两段分别处理。对这类用途来说,接缝通常不影响效果。
两个习惯:
- 切在语句边界上,不要切在字中间。模型对连续的说话声或完整的乐句处理得更好,对从半个音节开始的碎片处理得更差。
- 裁好的文件留着。同一段输入重跑分离,结果会有细微差别,对比时需要一份稳定的参照。
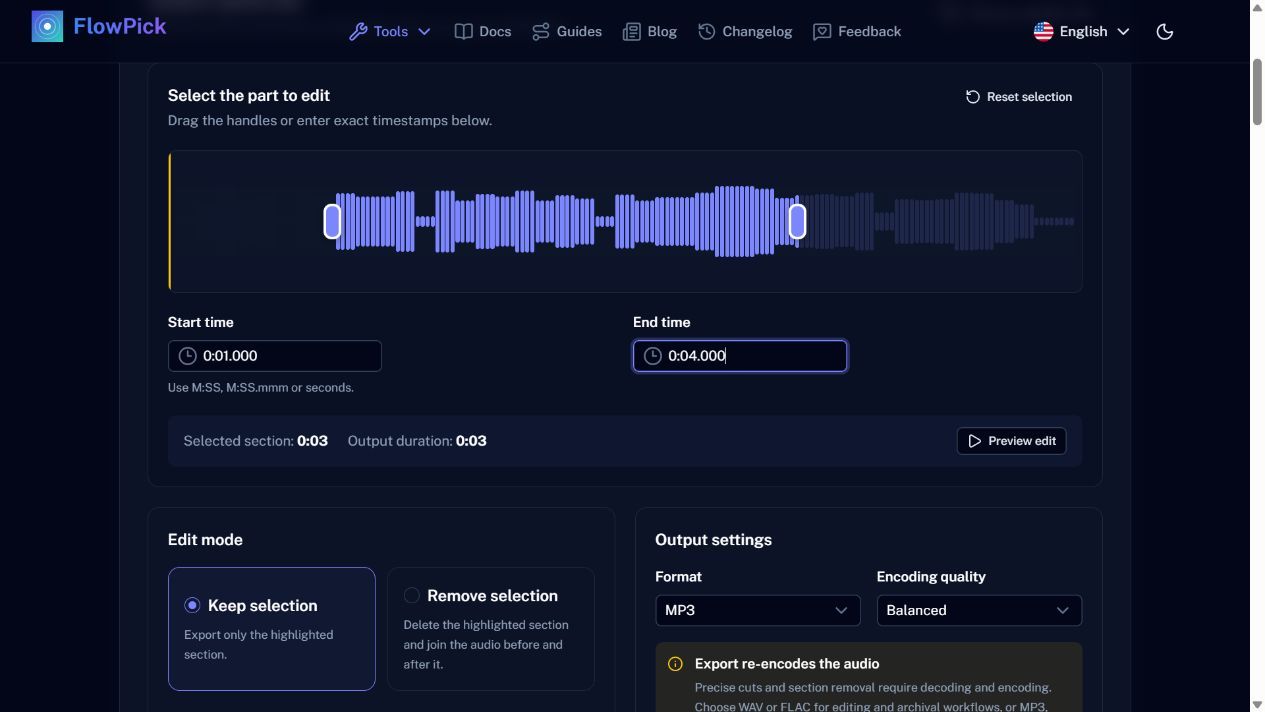
英文界面,生成语音样本中选中了 0:01–0:04。这张短样例演示控件操作,不代表已测试十分钟音乐。
第二步:先跑 30 秒预览,再决定要不要全跑
工具有前 30 秒的预览。用它。CPU 上跑全段可能是音频时长的好几倍,等二十分钟才发现输入不行,代价太大。
预览里重点听三件事:
串音。 放人声轨,听有没有鼓、贝斯或者混响尾巴。编曲密的曲子容易漏,编曲稀疏的通常没事。
变薄。 放伴奏轨,听人声是真的没了还是只是变小了。伴奏里残留人声是最常见的抱怨,这属于正常现象,不是故障。
音量关系。 两条轨用同一个输出增益导出,彼此是平衡的。预览里觉得某条明显更响,那是原混音的比例,不是导出的问题。
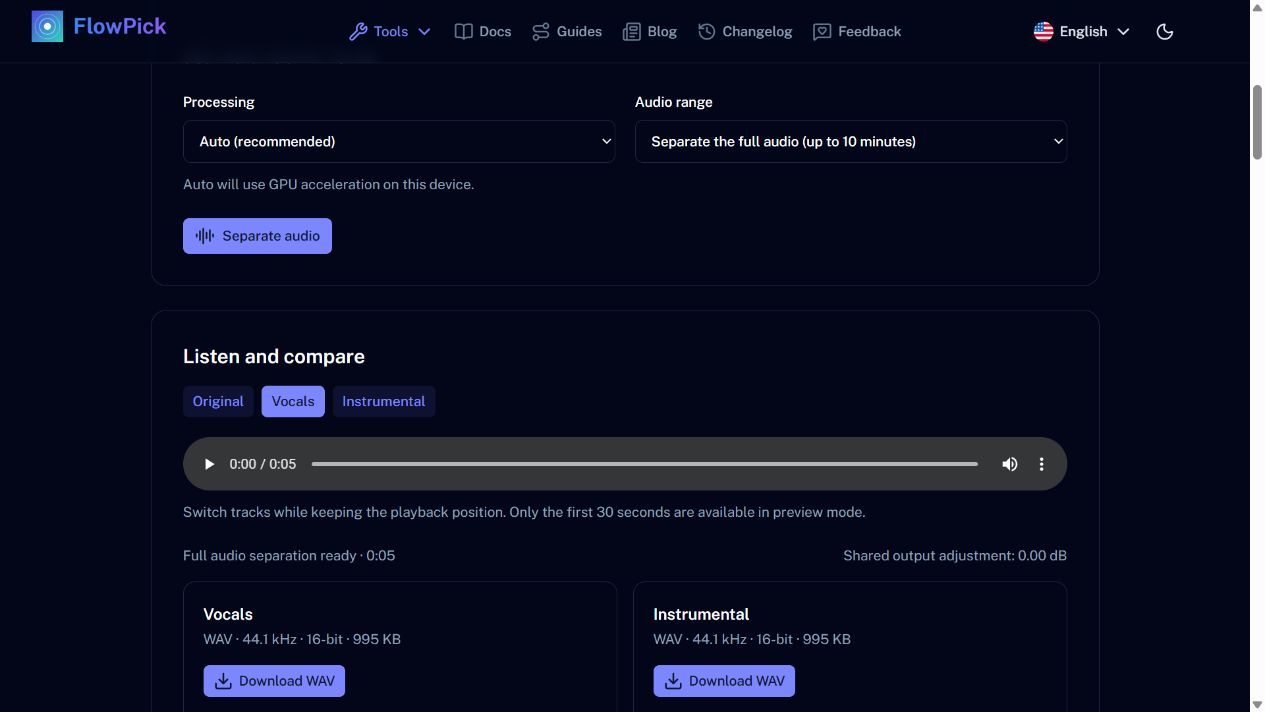
英文界面,使用生成语音演示,并非混音歌曲。分离结果不能用于证明音乐分离质量。
第三步:跑完整段并导出
开始分离,等它结束。浏览器能用 GPU 时会明显快一些;核显机器上会退回 CPU,并且提示可能需要音频时长的好几倍时间。
结果存在浏览器的临时空间里。刷新页面能在十分钟内找回,但那是便利,不是保存。跑完立刻把两条 WAV 下载到本地。
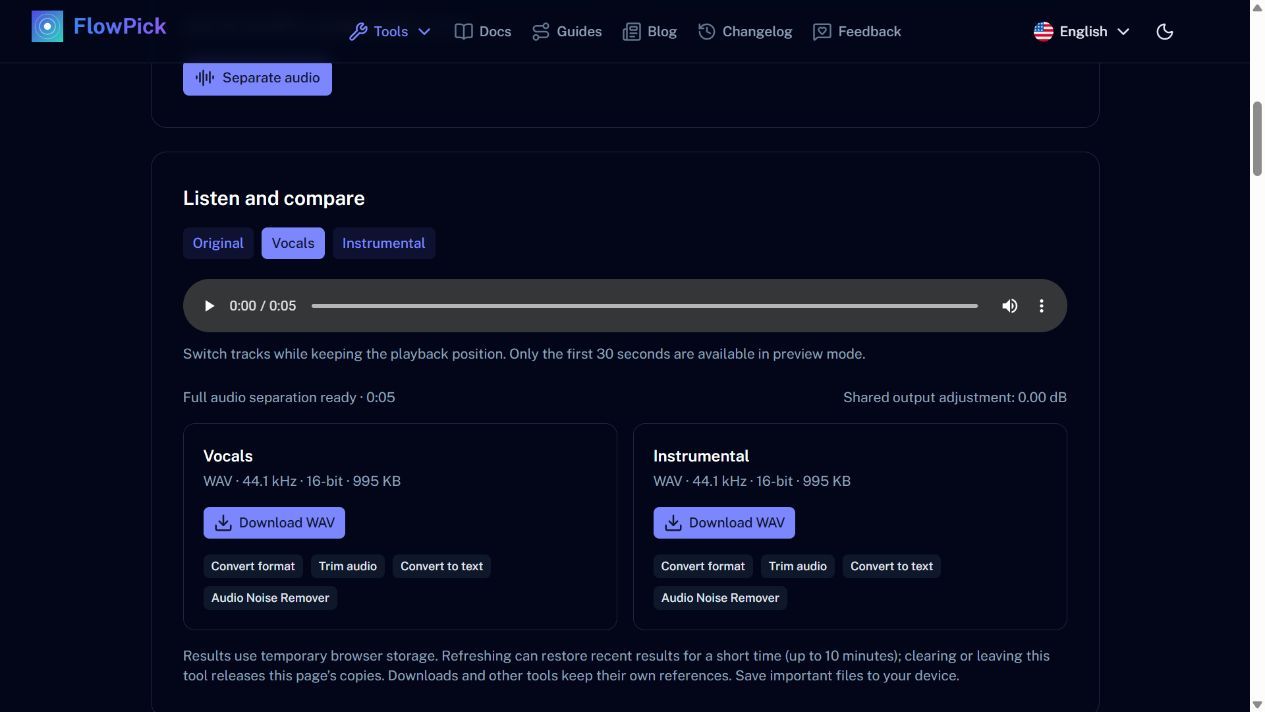
英文界面,实际完整处理了短生成语音样本。离开流程前应分别下载两个 WAV 文件。
拆出来的两条轨能干什么
转录这条值得单独提:它是少数"分离之后另一个工具的效果真的变好"的情况,而不只是产出一个你想要的文件。
分离效果不理想?先对号入座
文件被拒,说太长。 要么跳过了裁剪,要么选区本身还超过十分钟。限制算的是裁剪后的输出,不是源文件。
人声听起来像泡在水里。 分离痕迹过重。换同一首曲子的别的段落试试,密的段落比稀疏的难处理。
伴奏里还留着人声。 大部分素材都这样。这里没有"把人声再压一压"的选项——要从一个完整的混音母带里得到干净的伴奏,这个工具做不到。
CPU 上一直跑不完。 取消比干等好;不会丢东西,已完成的部分会被丢弃、临时文件会释放。缩短片段,或者换一台有可用 GPU 的机器。
期望值放在哪
两条 WAV,够用于练习、当伴奏、给转录做预处理,但达不到录音室分轨的水准。这个界限就是"浏览器本地的人声分离能做什么"的诚实答案。