
播客转文字:两小时的节目只转录你需要的那一段
按顺序使用的工具
最后得到什么: 一段八分钟的音频和它的文稿,而不是两小时的。
某人在播客里说了句有用的话。你大概记得位置——前三分之一,第二个广告之后。你需要准确的原话,用来引用、做笔记或者回复别人。
最直觉的做法是把整期转录成文字再搜。这确实可行,但也是最慢的一条路。这篇讲快的那条。
为什么"整期全转录"是错的默认选项
识别成本跟时长成正比。两小时的音频大约是半小时节目的四倍时间,产出的文稿里有九成跟你需要的那句无关。
播客本身的结构还有利于先剪:广告段、自我推广、重复的回顾,这些本来就是你听的时候要跳过的部分,却会原样进入转录。
正确的顺序是:一边快放一边定位、把那段剪出来、只转录那几分钟。
第一步:拿到播客的音频文件
找到音频源。多数播客页面上的音频就是一条 MP3 或 M4A 直链,确认的办法是在 Network 面板筛 media,或者看页面源码里的 <audio> 元素、RSS 里的 enclosure 地址。
把链接粘进音频下载器。它接受 MP3、M4A/AAC、WAV、OGG、FLAC 的直链。
如果这档播客给的是 HLS 音频清单而不是直链——平台托管的节目越来越常这样——改用 M3U8 下载器,读清单的做法见课程归档那篇。
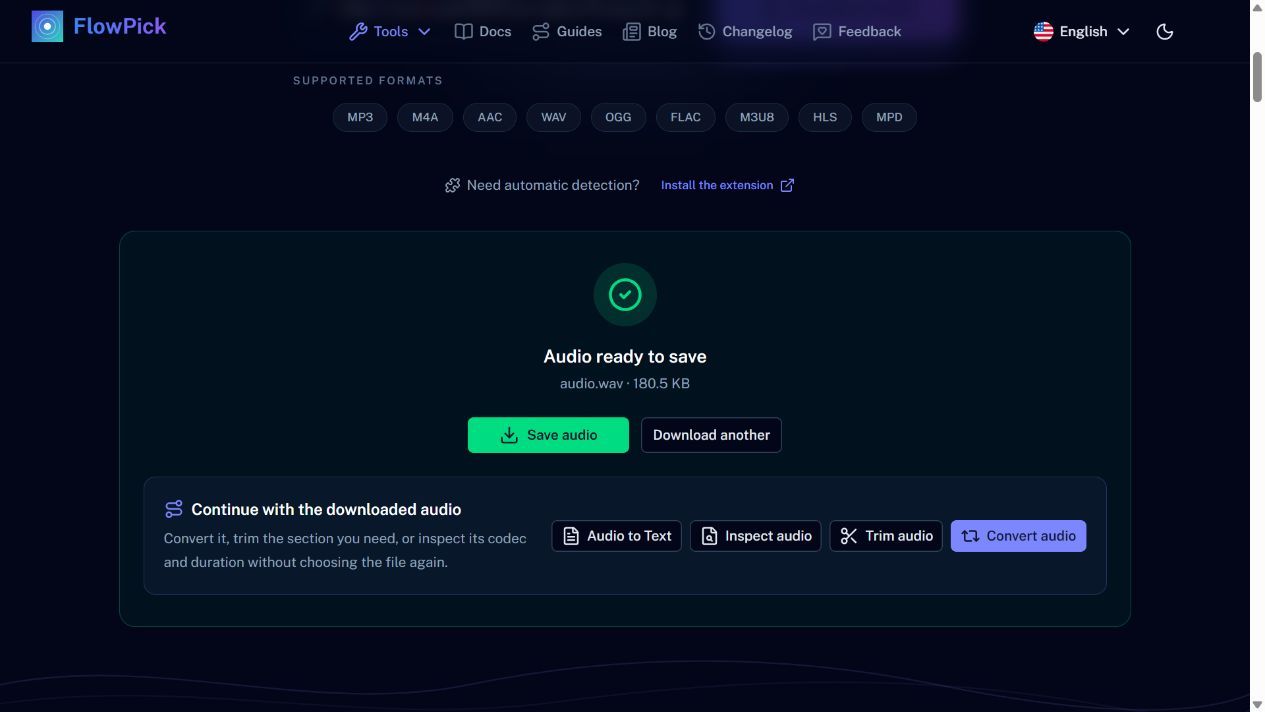
英文界面,直接获取本地公开地址上的生成语音,无需扩展。结果面板显示格式和体积;检查时长需点击 Inspect audio(检查音频)。
动手之前确认一件事:文件时长对不对。两小时的节目下来一个 12 分钟的文件,那是预告片,不是正片。
第二步:定位,然后剪出来
这是最多人跳过的一步,也是最能省时间的一步。
用音频裁剪打开下载好的文件。能快放就用 1.5 倍或 2 倍听,或者直接看波形拖,记下入点和出点。目标是一个两到十分钟的窗口,里面装着完整的论述——不是只要那一句。
故意剪宽一点是有原因的。三句话的文稿根本看不出这句话在回答什么,你最后还是得回去听。
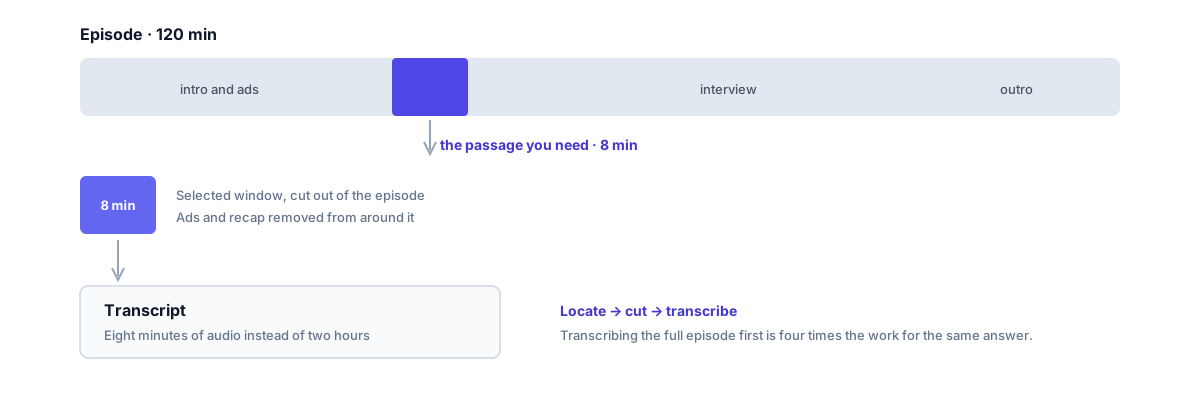
先定位,再剪,最后转录。顺序对了,这件事是几分钟,不是一小时。
顺手把前后文里的口播广告剪掉。那些内容没有信息量,而且是识别效果最差的部分——人声底下压着音乐和音效。
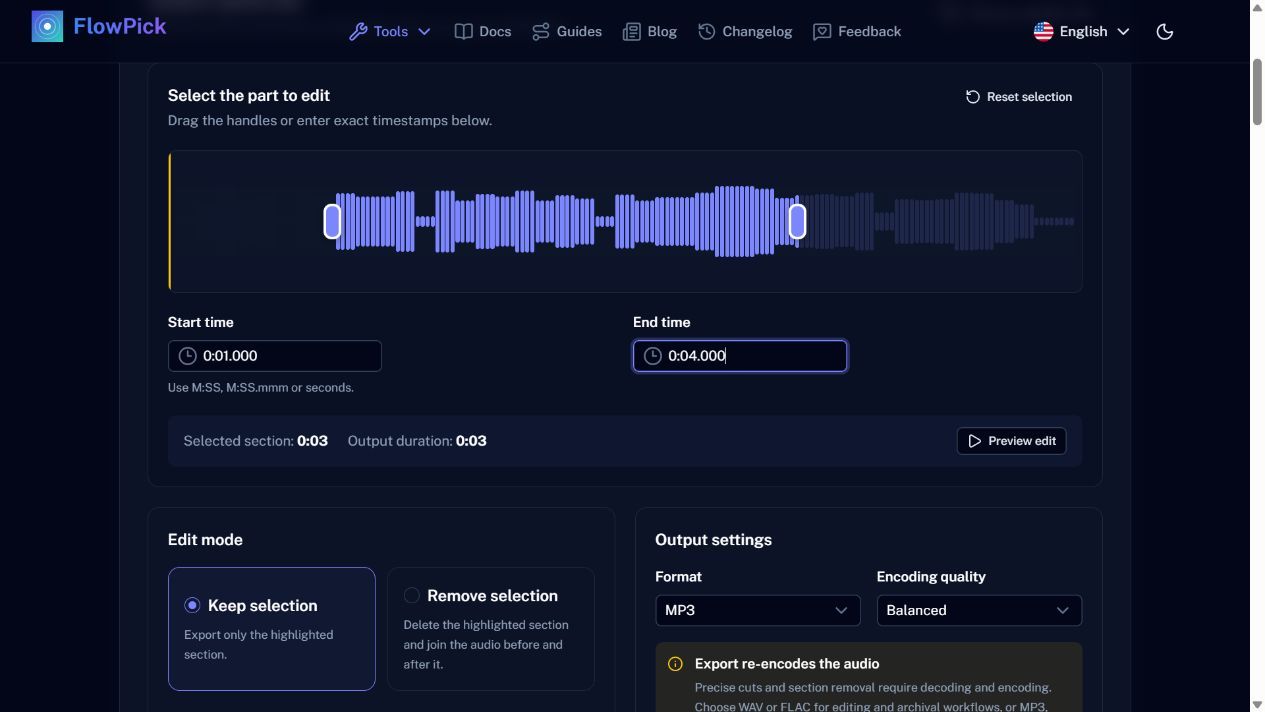
英文界面,使用生成语音演示,并非播客录音。在自己的节目中用同样的起止时间控件选取需要的八分钟片段。
第三步:转录这一段
把剪出来的片段交给音频转文字。播客音频通常是最容易处理的一类素材:一到两个人、像样的麦克风、语言稳定。
语言要自己指定,别依赖自动检测。检测是取开头几秒来判断的,而一段从句子中间开始的片段,可用的判断依据比整期少。
段落里有人名、数字或专业术语,选标准模型——需要引用的一段里通常都有。轻量模型够用来确认"对,就是这个部分"。
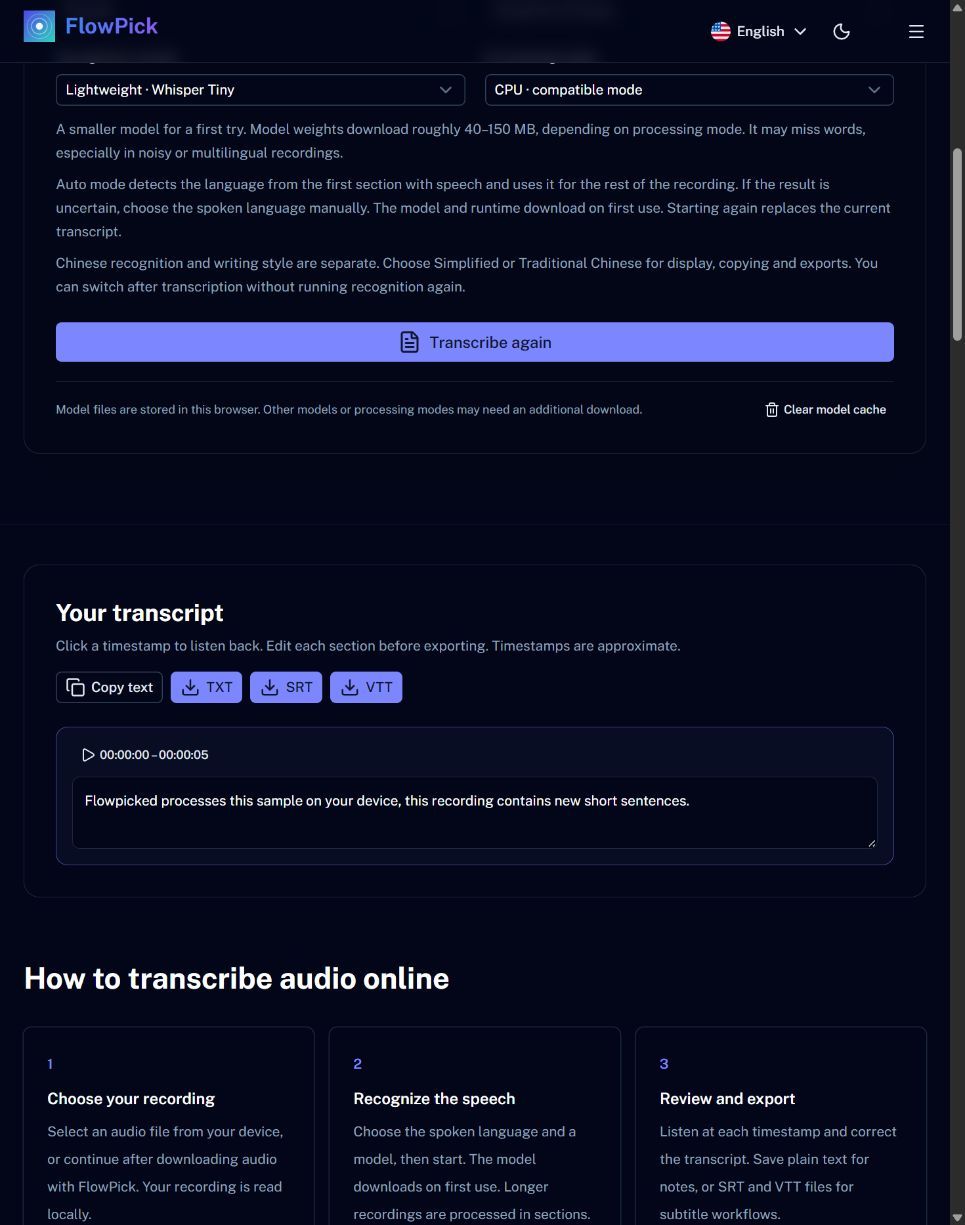
英文界面,Whisper Tiny 在 CPU 上实际识别生成的英语语音。这里只演示界面,不代表播客识别质量。
第四步:引用之前先核对
识别能抓到大概意思,但漏掉的正好是引用时最要紧的细节。把一句话归到某个人名下之前:
- 专有名词回到那个时间点重听一遍
- 数字重点核对——"十五"和"五十"是已知的易错点
- 确认是谁说的。这个版本不区分说话人,两人对谈时你得自己对上是哪一位
- 笔记里留下时间点。万一这个说法有争议,节目里的时间戳就是你的依据
文稿里的时间点是相对于你剪出来的片段,不是相对于整期节目。要在整期里标时间,记得加上第二步的偏移量。
中途出问题怎么办
下载链接 403。 播客 CDN 会给地址签名,复制来的链接会过期。重新打开节目页复制一条新的。
片段从半个字开始。 转录开头是个碎片,模型容易读错。入点比你以为的再多剪两秒。
文字都对,但顺序乱了。 长停顿和抢话会干扰分段。短片段一般手工调几下就好。
这期节目要登录才能听。 这套流程的前提是音频公开可访问。它不是付费墙的绕法,工具也没有往那个方向做。
收尾
一段八分钟的音频、它的文稿,两者都有时间点,再记一段"这个片段在整期里的偏移量"。音频以后还能再听一遍核对,光有文稿做不到。
播客和音频场景的更多做法,见播客与音频下载。