
会议录音转文字:把会议视频变成可搜索的纪要文稿
按顺序使用的工具
最后得到什么: 一个剪好的 MP4 用来分享,一份可编辑的文稿和 SRT 字幕。
会开完十分钟,就没人记得当时定了什么。录像是在的,但为了找一个数字去拖七十分钟的进度条,还不如没录。
这篇讲怎么把会议录像变成能搜索、能引用的文字:先剪、必要时转格式、再转录、最后校对。识别在你自己的浏览器里跑,全程不上传。
这套流程能做什么、不能做什么
产出是文稿:带时间点的文字,可以编辑,可以导出 TXT、SRT 或 VTT。这是写会议纪要的原料。
它不做摘要。"一键生成会议纪要"的按钮不存在,转录工具也不翻译、不区分说话人。纪要还是得自己写——不过从文稿里写,比对着视频写快得多,因为文字可以扫着读。
开始前有一个限制要清楚:识别在本地跑,所以时长直接等于等待时间。我们实测,七十分钟的会议用笔记本 CPU 转录,等待时间长到"先剪一下"从可选项变成了必选项。
第一步:转录之前先剪
把录像放进视频裁剪,剪掉两段:开头大家陆续进来、试麦克风的部分,和最后一个议题结束之后的闲聊。
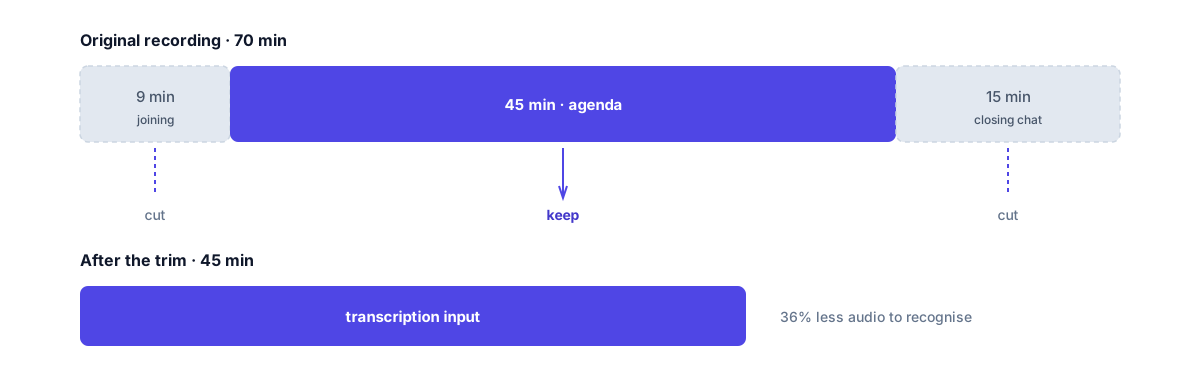
识别成本随时长增长。剪掉开头九分钟,就少了 13% 的工作量。
这一步收益最大,原因是算术而不是整洁:晚开始九分钟的会,剪完短了 13%,而剪掉的部分里没有任何你需要的信息。
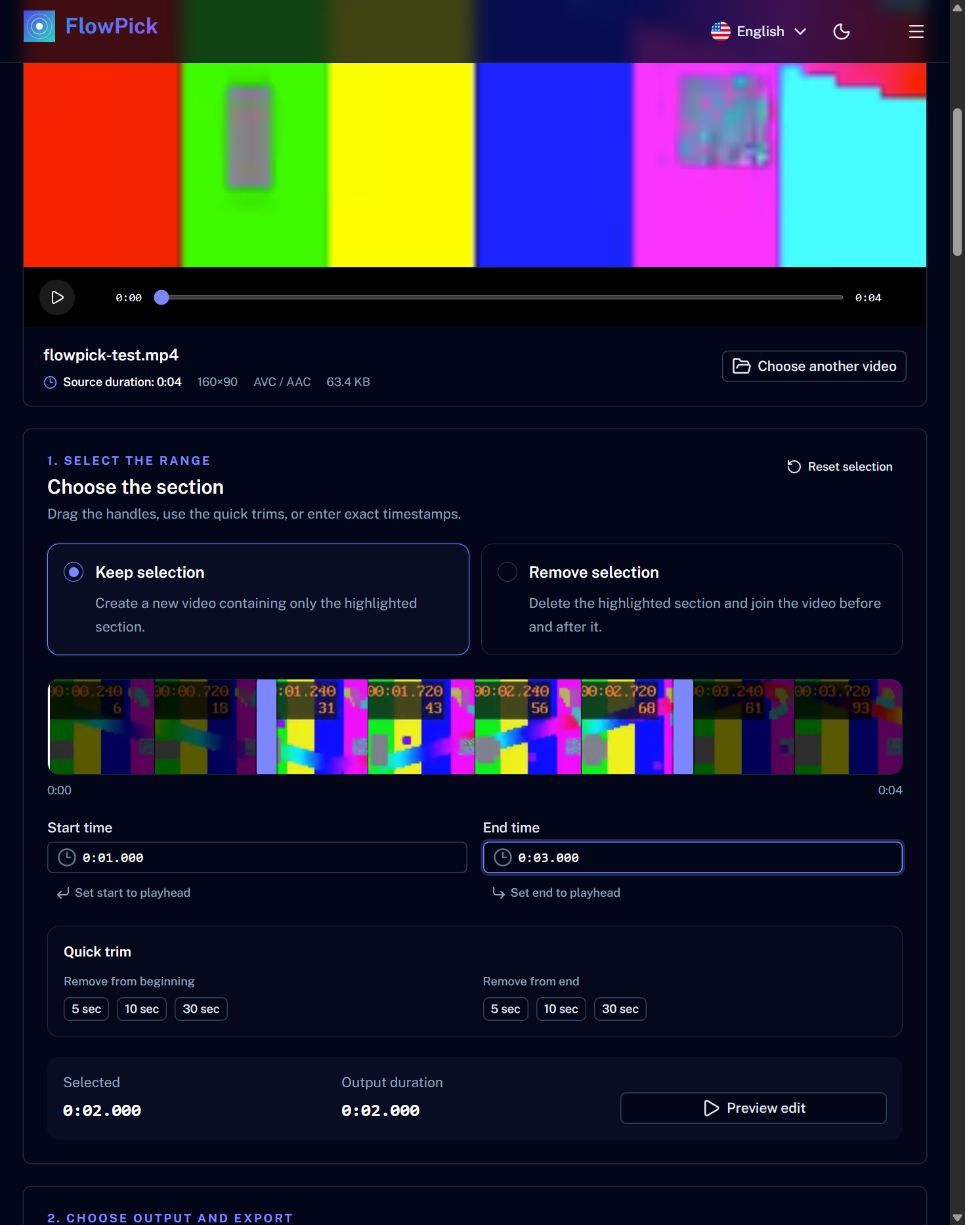
英文界面,使用 FlowPick 生成的四秒测试视频演示。高亮区保留 0:01–0:03;处理会议录制时使用同样的起止时间控件。
原件留着。裁剪产出的是新文件,等哪个结论说不清的时候,你还会想回去看没动过的版本。
第二步:转录失败时,才把 WebM 转成 MP4
浏览器的录屏工具和不少会议软件,写出来的是带 Opus 音频的 WebM。这格式本身没问题,转录器多数时候也能处理——但"多数时候"这四个字有分量:容器和音频解码的支持在 Chrome、Edge、Firefox 之间并不一致,而转录关心的恰恰是音轨,不是画面。
如果转录器提示无法解码音频,或者一句话都没识别出来,先用 WebM 转 MP4 换一次容器再重试。
转录本来就正常的话,跳过这步。给一个没问题的文件做转换,只是白等几分钟。
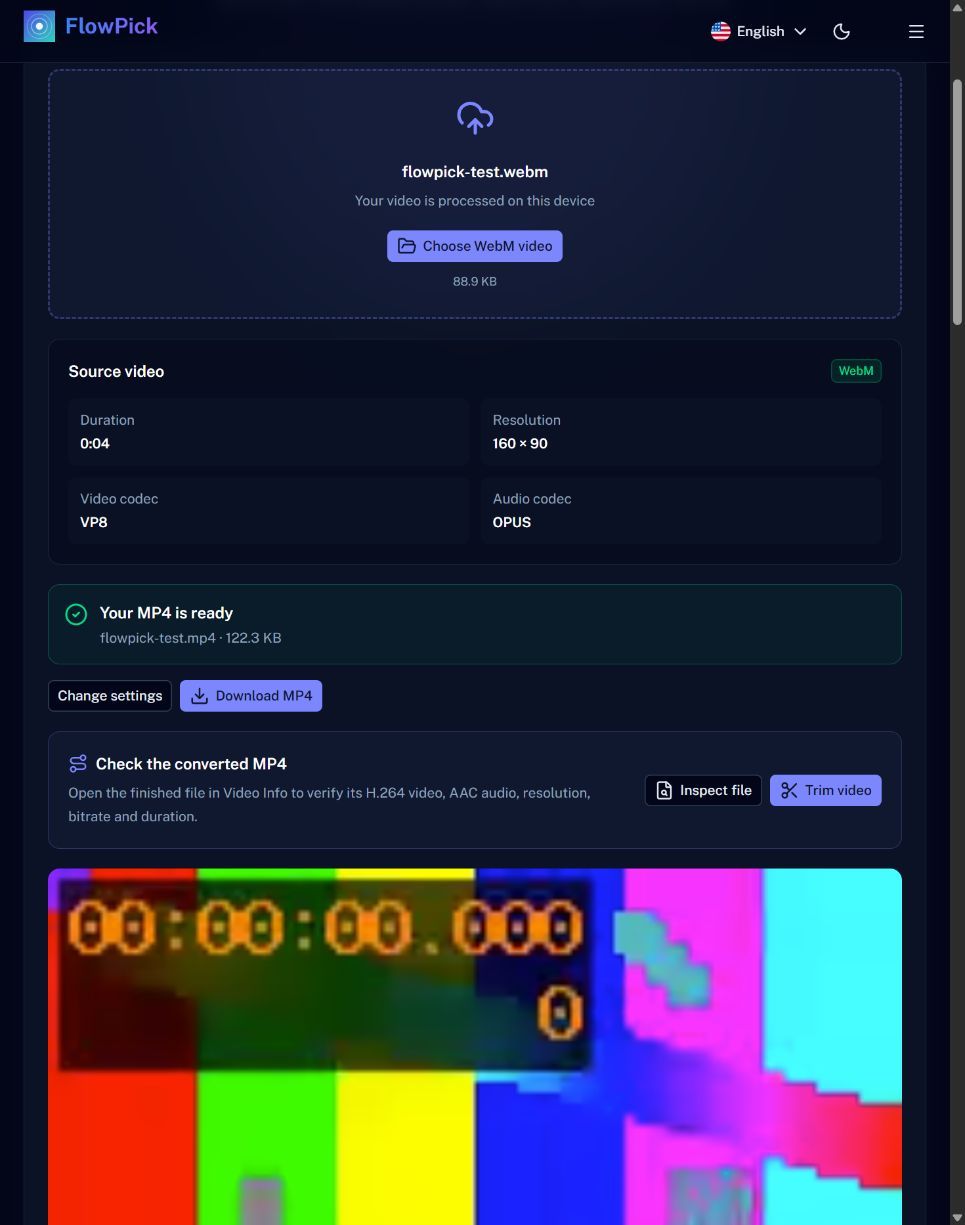
英文界面,使用生成的四秒测试视频:88.9 KB WebM → 122.3 KB MP4。工具会重新编码为 H.264/AAC,输出体积取决于源文件和设置。
第三步:转录,模型自己选
打开视频转文字,选中剪好的 MP4,设置语言,开始。
有两个设置直接决定你要等多久:
模型大小。 轻量模型下载 40–150 MB,只是要找到会上定了什么的话,够用。标准模型下载 80–250 MB,对人名和专业术语的识别更好,代价是时间和内存。会议里出现人名、产品名、数字的概率不低,我们多数时候选标准模型。
处理方式。 浏览器能用 GPU 时,GPU 加速明显更快。自动模式在无法确认有可用 GPU 时会退回 CPU,核显笔记本上很常见。
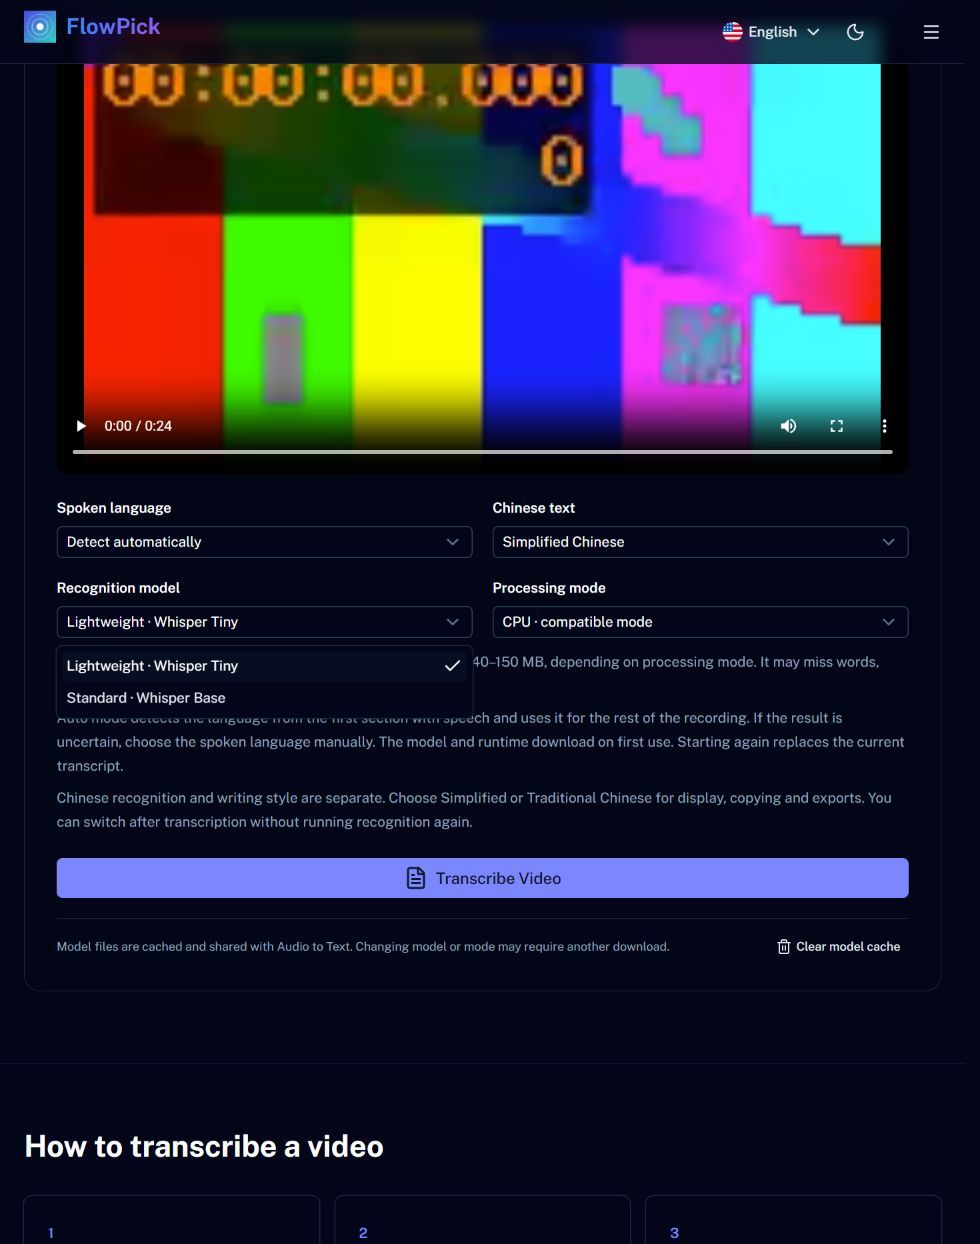
英文界面,使用生成的英语语音样本。模型和处理方式会影响首次下载体积与处理时间。
语言是最容易设错的一项。自动检测取第一段有人说话的内容判断,然后整段沿用;如果会议开头是两个人用别的语言寒暄,就会判错。知道会议用什么语言开,就直接选。
第四步:只校对要紧的部分
点时间点可以从那里开始播放,对着改文字。不需要全改:
- 人名、产品名——转写成中文时的同音字错位,引用出去最尴尬
- 数字、日期、金额——"十五"和"五十"是所有语音识别的经典易错点
- 待办事项和负责人——这是纪要里真正要落地的东西
语气词不值得花时间。
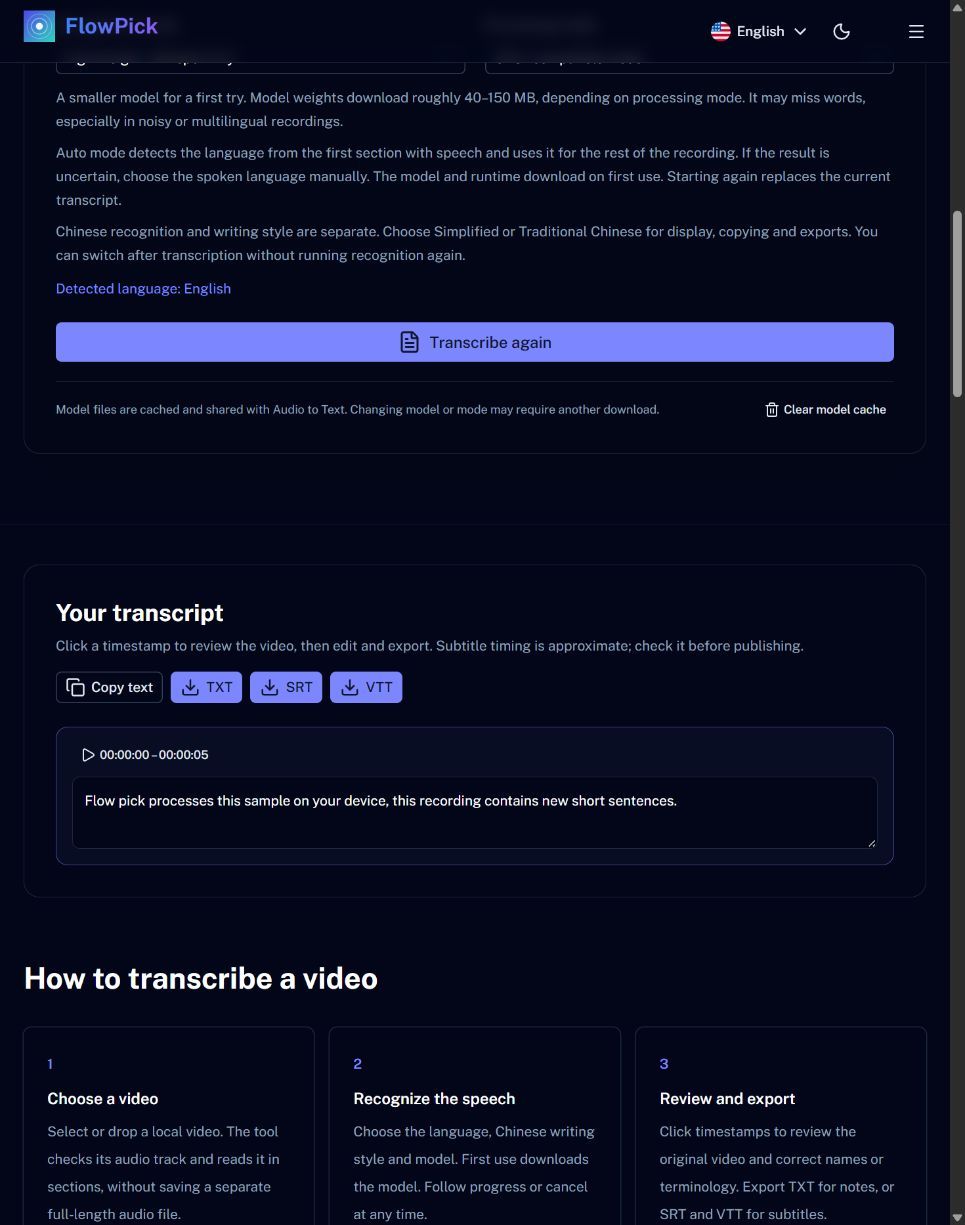
英文界面,Whisper Tiny 在 CPU 上识别生成语音后的未校正结果。它把"two short sentences"误识别为"new short sentences";引用前应回听校对。
时间点是近似值。如果这份文稿之后要当字幕用,做好在剪辑软件里重新对齐的准备,不要直接信。
转录中容易出问题的四个情况
开头的音乐把检测带偏。 多人抢话和背景音乐都会拉低识别率。第一步把片头剪掉,能解决大部分。
文稿是一大段没有分段的话。 输出按识别窗口切分,不按说话人或句子。写纪要时得自己重新组织段落。
长录音跑到一半停了。 已处理完的部分会保留。先把现有的导出,或者把源文件切成两半分别转录——浏览器内存不够时,这也是正经办法。
有人说的语言支持得不好。 这个版本支持工具里列出的那些语言,不同语言的效果差别不小,引用之前先核对。
收工时手里有什么
一次操作产出三个文件:剪好的 MP4 给想看视频的人,可编辑的文稿用来搜索和写纪要,需要字幕的话再导出一份 SRT。